
统计
标准差(SD)和标准误(SEM)的区别:误差棒该用哪个?
标准差(SD)描述各个数据点的离散程度;标准误(SEM)描述均值估计得有多精确,等于 SD 除以 √n。想让读者看到数据本身的变异时用 SD;图的重点是比较各组均值时,用 SEM 或 95% 置信区间。在 PivoGraph 中,误差棒的类型在 设置绘图格式 的 绘图 下拉框中切换,图会立即重画。
计算公式
| 统计量 | 公式 | 样本量增大时 |
|---|---|---|
| SD | √[ Σ(x − x̄)² / (n − 1) ] | 趋于总体的真实离散程度 |
| SEM | SD / √n | 持续变小 |
| 均值的 95% CI | x̄ ± t × SEM,t 取自由度为 n − 1 的 t 分布 | 持续变小 |
由于 SEM 要除以 √n,只要一组有两个及以上的值,SEM 就一定小于 SD。n = 3 时 SEM 约为 SD 的 0.58 倍;n = 17 时(即下面的示例)约为 0.24 倍。
同一组数据,两种误差棒
下面两张图是同一组眼压数据,每个时间点 17 只眼。
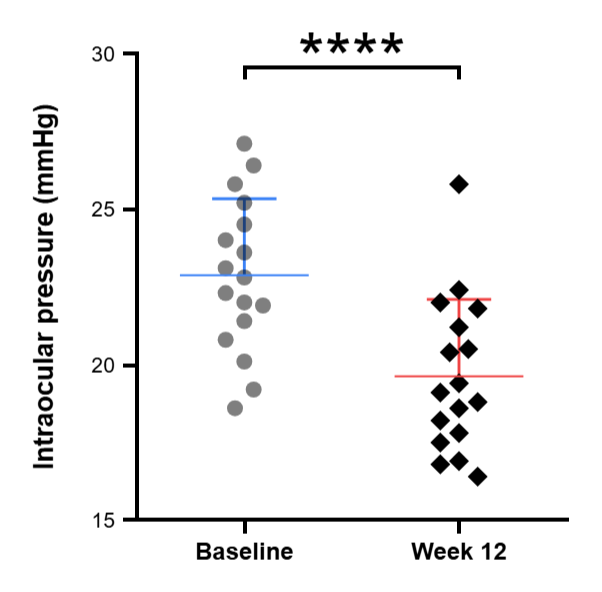
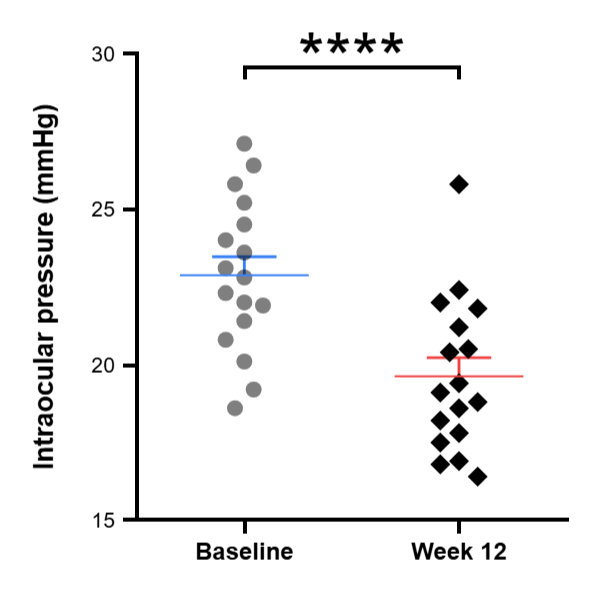
基线时 SD 为 2.46 mmHg,SEM 为 0.60 mmHg。SD 误差棒覆盖了大部分眼睛的数值,大约在 20 到 25 mmHg 之间;SEM 误差棒只在均值上下各 0.6 mmHg,它反映的是均值估计得有多精确,而不是各只眼的数值范围。
该用哪个
- SD:样本之间的差异本身就是结果的一部分时,比如动物或患者之间的个体差异有多大。
- SEM:图的重点是比较各组均值,并且图注写明了 n。每组样本量小时,最好同时画出每个数据点,就像上面两张图一样。
- 95% CI:比较均值、并希望读者直接判断差异大小时。两组独立数据的 95% CI 不重叠时,差异在 P < 0.05 水平上显著。
无论选哪种,都要在图注中写明,并注明 n,例如「均值 ± SD,n = 17 只眼」。判断两组均值是否不同,应该做统计检验,而不是看误差棒是否重叠,见t 检验怎么做。
在 PivoGraph 中切换误差棒
- 在 图表视图 中点击右侧面板栏的 绘图,打开 设置绘图格式。
- 在 绘图 下拉框中选择 均值 + SD、均值 + SEM 或 均值 + 95% CI。
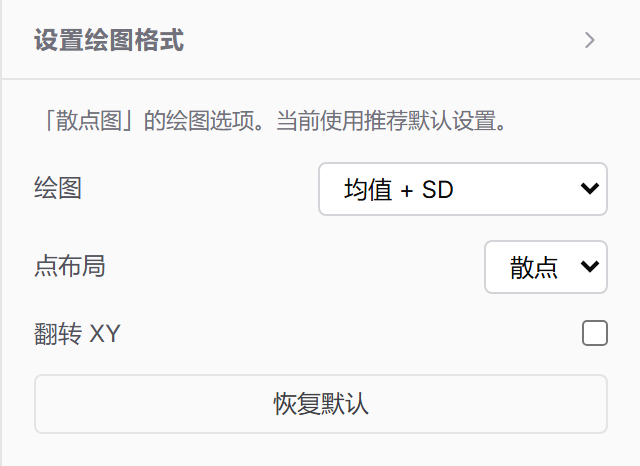
柱状图和带均值线的散点图都按这种方式设置。生长曲线这类 XY 图,在 绘图 中选择 均值与误差,再在 误差 中选择 SD、SEM 或 95% CI,见如何画带误差线的折线图。
计算每列的 SD 和 SEM
- 点击右侧面板栏中的 分析。
- 在 方法 页选择 描述统计。
- 打开 结果 页。
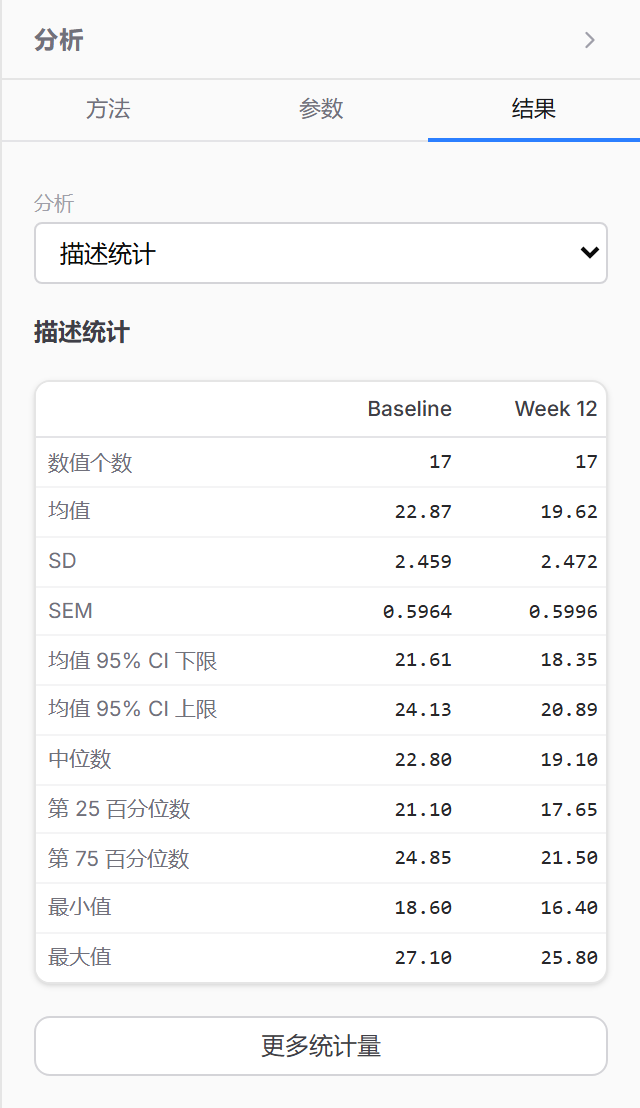
表中列出每一列的数值个数、均值、SD、SEM、均值的 95% CI、中位数、四分位数、最小值和最大值。点击 更多统计量 还会显示变异系数、几何均值、偏度和峰度。
常见问题
SD 的分母是 n 还是 n − 1? n − 1,即样本标准差。SEM 和置信区间都以它为基础。
为什么有一组没有误差棒? 计算 SD 和 SEM 至少需要两个值,只有一个值的组不画误差棒。
计算结果准确吗? 描述统计、四分位数和百分位数都已在验证页与 R 逐值对照。